
文 | 人文社遂宁股票配资
编辑| 人文社
«——【引言】——»
2026年10月,全球半导体与人工智能领域抛出了一份让人倒吸一口凉气的市场统计数据:
在咱们中国的AI芯片市场里,华为昇腾系列的市场份额直接飙破了50%,硬生生把曾经高不可攀的英伟达挤下神坛,坐上了头把交椅。而那个在四年前几乎垄断了全中国95%算力底座的“绿色巨人”英伟达,现在的份额居然已经跌穿了8%。
眼看这形势,老美那边估计肠子都悔青了。
但把日历往前翻两页,回到2022年的那个秋天。那时候,大洋彼岸的制裁大棒挥舞得多么虎虎生风啊。
高算力的A100、H100芯片被一刀切断,硅谷的科技巨头和华盛顿的政客们坐在真皮沙发上,自信满满地端着咖啡,认定只要掐断了这根管子,中国轰轰烈烈的大模型研发就会瞬间断水断电,直接被打回“算力原始时代”。
那时候的英伟达,在大脑皮层上都刻着“垄断”两个字,咱们自家地盘上的华为昇腾,份额可怜巴巴地只有3%。
谁敢信?短短一千多个日夜,四年时间,这场被无数人看衰的“算力绝境”,居然硬生生演变成了一场科技史上最魔幻的“反向大练兵”。
封锁不仅没把咱们的AI产业饿死,反而像一记响亮的耳光,把全球规模最大、增速最猛的AI算力市场,拱手喂给了中国自研生态。
连黄仁勋黄教主最近对着镜头都只能无奈摊手,公司内部的财务预测里,对中国先进芯片市场的销售预期,直接填了个醒目的“鸭蛋”。单单今年一季度,英伟达就因为卖不出去货,砸手里一堆资产,一口气吞下了几十亿美元的减值损失。
而另一头,华为今年的AI芯片营收眼瞅着就要冲破120亿美元大关了。
这早就不是什么简单的“东风压倒西风”的市场戏码了,这是一场被死胡同逼出来的工业奇迹。今天咱们就掰开揉碎了聊聊,这四年,到底发生了什么?
妥协的“阉割卡”,怎么就把金主逼反了?
英伟达是怎么把手里一副天牌打得稀烂的?其实答案透着一股子傲慢。
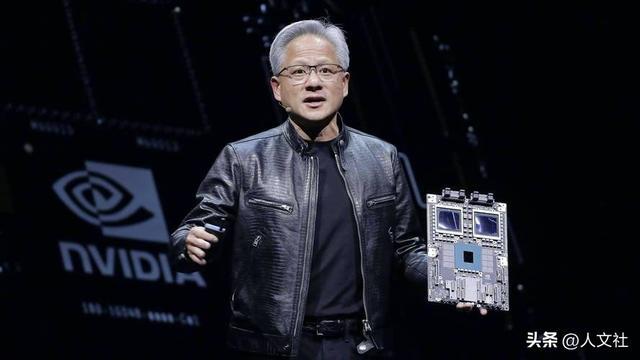
当年禁令一收紧,英伟达急了,中国这块肥肉谁舍得吐出来?于是他们搞出了一个极具黑色幽默的产物——“合规特供卡”H20。为了卡住美国商务部规定的算力上限,英伟达工程师硬是把H20的计算核心砍到了H100的20%左右。
但大模型这玩意儿要吞吐海量数据啊,算力砍了,显存和带宽又不敢缩水太多。
这玩意儿在懂行的人眼里,滑稽到了什么程度?你想象一下,你去4S店买一辆法拉利,销售告诉你:“哥,为了合规,我们把这台原本能跑350迈的V12发动机拆了,给你换了个1.0排量的割草机电机。但是你放心,后备箱我给你加大了,油箱也贼大,售价嘛,还是1.5万美元,概不讲价!”
一开始,国内那些正处于“大模型百团大战”焦虑期的大厂们,为了救急,捏着鼻子也买了一批。但这帮互联网巨头里养的都是什么人?那是全中国最精打细算的账房先生和架构师。
用不了几个月,大家在机房里一跑数据,底裤全漏了。用这种“瘸腿马”去拉大模型训练这辆重型马车,算力太弱导致训练周期被无限拉长,时间成本直接爆表;要是拿去做推理端,单卡价格又贵得离谱,电费和折旧费算下来,简直是在烧钱。
更要命的是那种悬在头顶的达摩克利斯之剑。你今天花几百亿人民币买了H20建机房,谁知道明天华盛顿会不会一纸公文,连H20的电源线都给你禁了?在别人的地基上盖摩天大楼,连睡觉都得睁着一只眼。
当华强北渠道里的水货价格崩盘,当大厂老板们彻底放弃了对“特供卡”的幻想,一个历史性的转折点就出现了:砸下几百上千亿资本支出的买家们,终于下定决心,长痛不如短痛,算力底座全量切向国产。
算力大后方:不拼“单挑”,咱们玩“群殴”
切向国产,说得轻巧,做起来那就是脱层皮。华为轮值董事长徐直军在公开场合从不避讳一件事:受限于客观的制造工艺,咱们单挑一颗芯片的物理极限制程,确实跟人家有差距。
但是,AI算力的战场,早就不是两个剑客在紫禁之巅单挑了。这可是几十万大军协同作战的重装阵地战。
训练一个千亿甚至万亿参数的大模型,就像是几十万个建筑工人同时在造一栋几百米高的摩天大楼。英伟达的芯片确实是个体能爆表的超级工人,搬砖速度快得惊人。
但是,当几万张卡连在一起的时候,只要有一张卡因为过热宕机了,或者卡跟卡之间传递图纸的时候卡顿了0.1秒,整个几万人的工地就会瞬间停工。
中国工程师摸索出了一套极其硬核的“系统工程”解题思路。单兵作战我稍微吃点亏?没关系,我靠严密的组织纪律和超强的后勤补给把优势抢回来。
早在2018年,华为就默默埋下了一颗种子——达芬奇架构。这玩意儿把标量、向量和矩阵三种计算单元揉进了一块核心里,天生就是为了大模型这种密集矩阵计算准备的。
更绝的是修路。芯片再多,数据堵车也白搭。华为搞出了HCCL集合通信库和灵衢总线协议,这就相当于在芯片之间修建了全无阻塞的超车道。
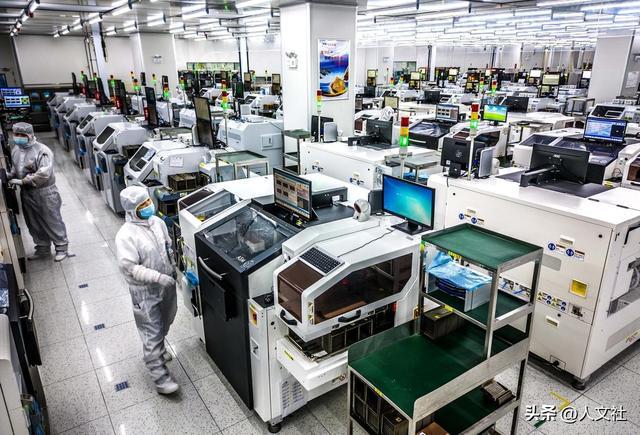
你去看DeepSeek在内蒙古那些冷得让人直哆嗦的数据中心里,直接堆了超过16万张华为昇腾加速卡。
16万张卡啊!这要是在过去,光是线路短路和节点掉线就能把运维工程师逼疯。但华为靠着软硬一体的网络隔离和秒级自愈机制,硬是让这种万卡集群在长达几个月的不间断训练中,稳定运行率达到了恐怖的99%以上。
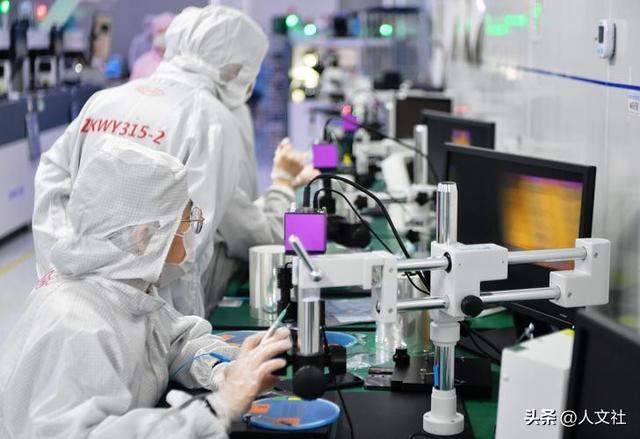
一颗不够快,我就用一万颗无缝焊死在一起。当单卡那点微弱的性能差距,被庞大集群极其恐怖的有效吞吐量彻底稀释掉的时候,硅谷引以为傲的“单芯片护城河”,就被咱们这种大规模异构集群的“群殴战术”硬生生地推平了。
拆掉CUDA那堵墙:现实版的“偷梁换柱”
硬件能造出来,能连起来,其实只赢了一半。业界一直有句大实话:真正拦住大家换掉英伟达的,根本不是硅片,而是那个叫CUDA的软件生态。
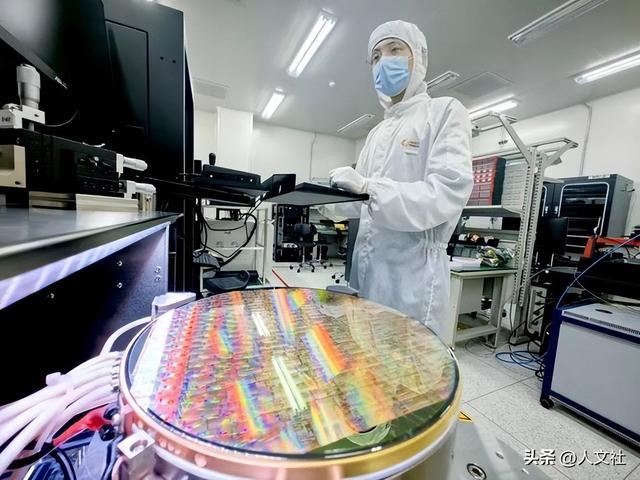
过去十几年,全世界几百万个AI程序员,写代码的习惯早就被英伟达的CUDA死死绑架了。这就好比全天下的厨子都习惯了用某种特定品牌的菜刀和铁锅,你突然给他们换一套外星人用的炊具,还要他们做出一桌满汉全席。
要让程序员推翻几十万行底层代码重写?那比杀了他们还难受。
华为在这里展现出了极高的战略智慧,他们没有头铁去搞一套门槛极高的“全新语言”,逼着大家从拼音学起。他们搞了一个堪称神来之笔的“智能外挂翻译盒”——CANN异构计算架构。
这玩意儿有多好用?大白话说,各大厂的程序员拿到华为的机器,代码基本不用大改。你只要在原有的PyTorch开源框架代码里,把声明设备的那行字,从`cuda`敲键盘改成`npu`,剩下的上万行深度学习逻辑,原封不动!底层的翻译和适配,全交由CANN在暗中接管、极速运行。
到了2025年下半年,华为干脆把CANN底层全面开源了。这一下彻底点燃了开发者的热情,外面社区里帮忙添砖加瓦的非华为程序员,数量早就碾压了华为自家的工程师。
底座稳了,翻译器也顺手了,接下来就是见证奇迹的时刻。阿里云、字节跳动、通义千问、DeepSeek……这些我们每天都在用的主流大模型,上演了一场云计算历史上最惊险的“万米高空换引擎”。
在几亿普通用户每天都在正常提问、画图、写文章的毫秒之间,前台业务毫无卡顿,但底层的算力骨架,已经被悄无声息地彻底替换成了国产算力栈。这种悄无声息,恰恰是技术自立最震耳欲聋的号角。
命运的齿轮:硬生生砸出来的“双轨制”
跳出纯技术的圈子,咱们站在商业规律的角度往下看一眼,你就会发现美国那几份断供禁令,干了一件多么愚蠢且违背经济学常识的事情。
原本,中国厂商每年都要拿着几百亿美元的真金白银,去硅谷排队买芯片。这笔巨额的利润,支撑着英伟达们不断招揽顶尖人才、研发下一代更强的技术,形成了一个牢不可破的垄断飞轮。
但是一纸禁令,强行把这几百亿美元的输血管给切断了。这笔原本要流向海外的惊天巨资,就像遇到了堰塞湖,只能猛地调转车头,像山洪暴发一样,劈头盖脸地灌溉给了华为、寒武纪这些本土的半导体企业。
有了钱,就能砸研发;产品出来了有人买单,就能迅速发现bug并迭代升级。造血循环一旦打通,国产芯片“研发、回血、再升级”的飞轮,就以一种无法阻挡的势头狂飙起来了。
这场长达四年的博弈,最终把全世界的AI算力体系,硬生生逼成了一个前所未有的“双轨制”。
一根轨道,是西方阵营里,以英伟达硬件和CUDA闭环组成的护城河;而另一根轨道,赫然是中国基于昇腾硬件、开源CANN中间件以及顶尖本土大模型算法,千锤百炼打磨出来的软硬一体化全栈生态。
当DeepSeek们在国产底座上跑得越来越丝滑,当这套“中国算力+中国模型”的组合拳展现出极其恐怖的性价比和绝对的供应链安全时,临界点其实已经被越过了。
历史总是喜欢开这种极具反讽意味的玩笑。那些原本打算用来封死我们门窗的铁板,最后被里面的人硬生生拆了下来,叮叮当当地重新锻造,打成了一艘通往下一代工业革命的航母甲板。
现在,国产算力不仅在国内大厂的机房里站稳了脚跟,面对未来必然会向全球市场外溢的高性价比自研生态,压力遂宁股票配资,终于来到了硅谷那边。
文章为作者独立观点,不代表联华证券-股票配资开户-正规配资开户观点
- 上一篇:股票杠杆网站平台 游客一进县城就收到文旅局长的姓名和个人手机号,工作人员:是真的
- 下一篇:没有了
相关文章